글자 깨짐이란?
가끔 텍스트 파일의 중국어가 영문을 알 수 없는 기호로 바뀌어, 엉망진창에 아무 논리도 없어 보일 때가 있다. 이것이 글자 깨짐이다.
글자는 왜 깨질까?
섹션 제목: “글자는 왜 깨질까?”텍스트를 작성할 때 쓴 인코딩이 아닌 다른 인코딩으로 텍스트를 열었기 때문이다.
인코딩마다 문자를 정하는 규칙이 다르다.
인코딩이란?
섹션 제목: “인코딩이란?”인코딩은 문자 인코딩이라고도 한다. 쉽게 말해 컴퓨터의 “사전”이다. 텍스트 파일은 컴퓨터 안에 글자 그대로 저장되지 않고, 이진수 열로 표현된다. 예를 들어 보자.
컴퓨터에 A 인코딩을 쓰게 하고 “人”을 입력하면, 컴퓨터는 “人”을 A 인코딩에서 “人”에 해당하는 이진수로 바꾼다. 이 이진수가 0010011이라고 하자.
다시 열 때 B 인코딩을 쓰면, 컴퓨터에 저장된 이진수는 여전히 0010011이다. 컴퓨터는 B 인코딩의 문자표에서 이 이진수에 해당하는 글자를 찾는다. B 인코딩에서 0010011이 “你”라면, 텍스트를 다시 열었을 때 “人”이 “你”로 바뀌어 보인다.
물론 실제 인코딩 규칙은 이렇게 단순하지 않다. 글자가 왜 깨지는지만 이해하면 충분하다.
글자 깨짐의 유형
섹션 제목: “글자 깨짐의 유형”자신의 텍스트가 어떻게 깨졌는지 알아보기 쉽게 표로 정리했다.
| 이름 | 예시 | 특징 | 원인 |
|---|---|---|---|
| 고문(古文)형 | 宀佺殑娉曞浗浜嗗緢涔 | 대부분 알아볼 수 없는 옛 한자이고, 일본어·한국어 문자가 섞여 있다 | UTF-8로 인코딩된 중국어를 GBK로 읽음 |
| 네모형 |  | 대부분의 문자가 작은 네모로 보인다 | GBK로 인코딩된 중국어를 UTF-8로 읽음 |
| 기호형 | å²çæ³å½äºå¾ä¹ | 대부분의 문자가 각종 기호다 | UTF-8로 인코딩된 중국어를 ISO8859-1로 읽음 |
| 병음형 | ËêµÄ·¨¹úÁ˺ܾà | 대부분의 문자가 머리에 여러 성조 기호가 붙은 알파벳이다 | GBK로 인코딩된 중국어를 ISO8859-1로 읽음 |
| 물음표형 | 好好学习天天?? | 문자열 길이가 짝수면 정상이고, 홀수면 마지막 문자가 물음표로 바뀐다 | UTF-8로 인코딩된 중국어를 GBK로 읽은 뒤, 다시 UTF-8 형식으로 읽음 |
| 锟拷(쿤카오)형 | 锟斤拷锟斤拷锟斤拷锟斤拷锟斤拷 | 전부 한자이고, 대부분이 “锟斤拷”라는 문자들이다 | GBK로 인코딩된 중국어를 UTF-8로 읽은 뒤, 다시 GBK 형식으로 읽음 |
해결법도 간단하다. 깨진 모양의 특징을 보고 변환하거나, 원래 인코딩으로 다시 열면 된다.
인코딩 설정과 변환
섹션 제목: “인코딩 설정과 변환”VS Code를 예로 들어 보자.
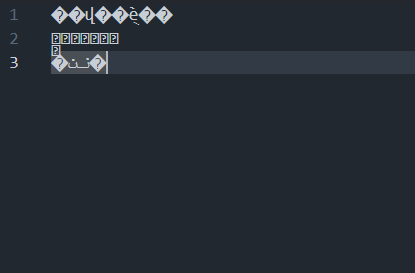
전형적인 네모형이다.
VS Code 오른쪽 아래를 보자.

UTF-8을 누른다.
그다음 GBK로 다시 열면 된다.
